记一次华为杯数学建模协作经验
记录华为杯数学建模三人协作的一次实践:在 Windows 上用 Docker 自建 Overleaf 并通过校园网共享,把没有官方 API 的 CE 版逆向成一套 CLI,再用 DeepSeek Harness(管同步)与 Codex(管写作)围绕同一个本地文件夹搭起写作闭环。
前言
研赛的节奏是这样的:9 月 23 日早上八点开题,9 月 27 日中午十二点前必须提交论文的 MD5 码——四天四小时,三个人,一篇几十页的论文。
先交 MD5、再传正文,意味着十二点那一刻你的文件必须已经是最终版,改一个字节都对不上。关于论文写作,如果用word的话,调整格式太麻烦了且不方便AI操作;如果使用latex的话,三个人各自在本地写 .tex,合并的时候宏包冲突、\label 重名、图片路径不对、公式编号全乱。
所以华为杯之前,我提前做了两件事:
- 用 Windows 电脑 + Docker 搭一个属于我们三个人的 Overleaf,通过校园网这个大局域网共享出去;
- 让 DeepSeek Harness 和 Codex 两个 AI 代理接管 LaTeX 的同步与写作(这一部分只针对笔者工作而言)。
这篇文章就是这两件事的完整记录。
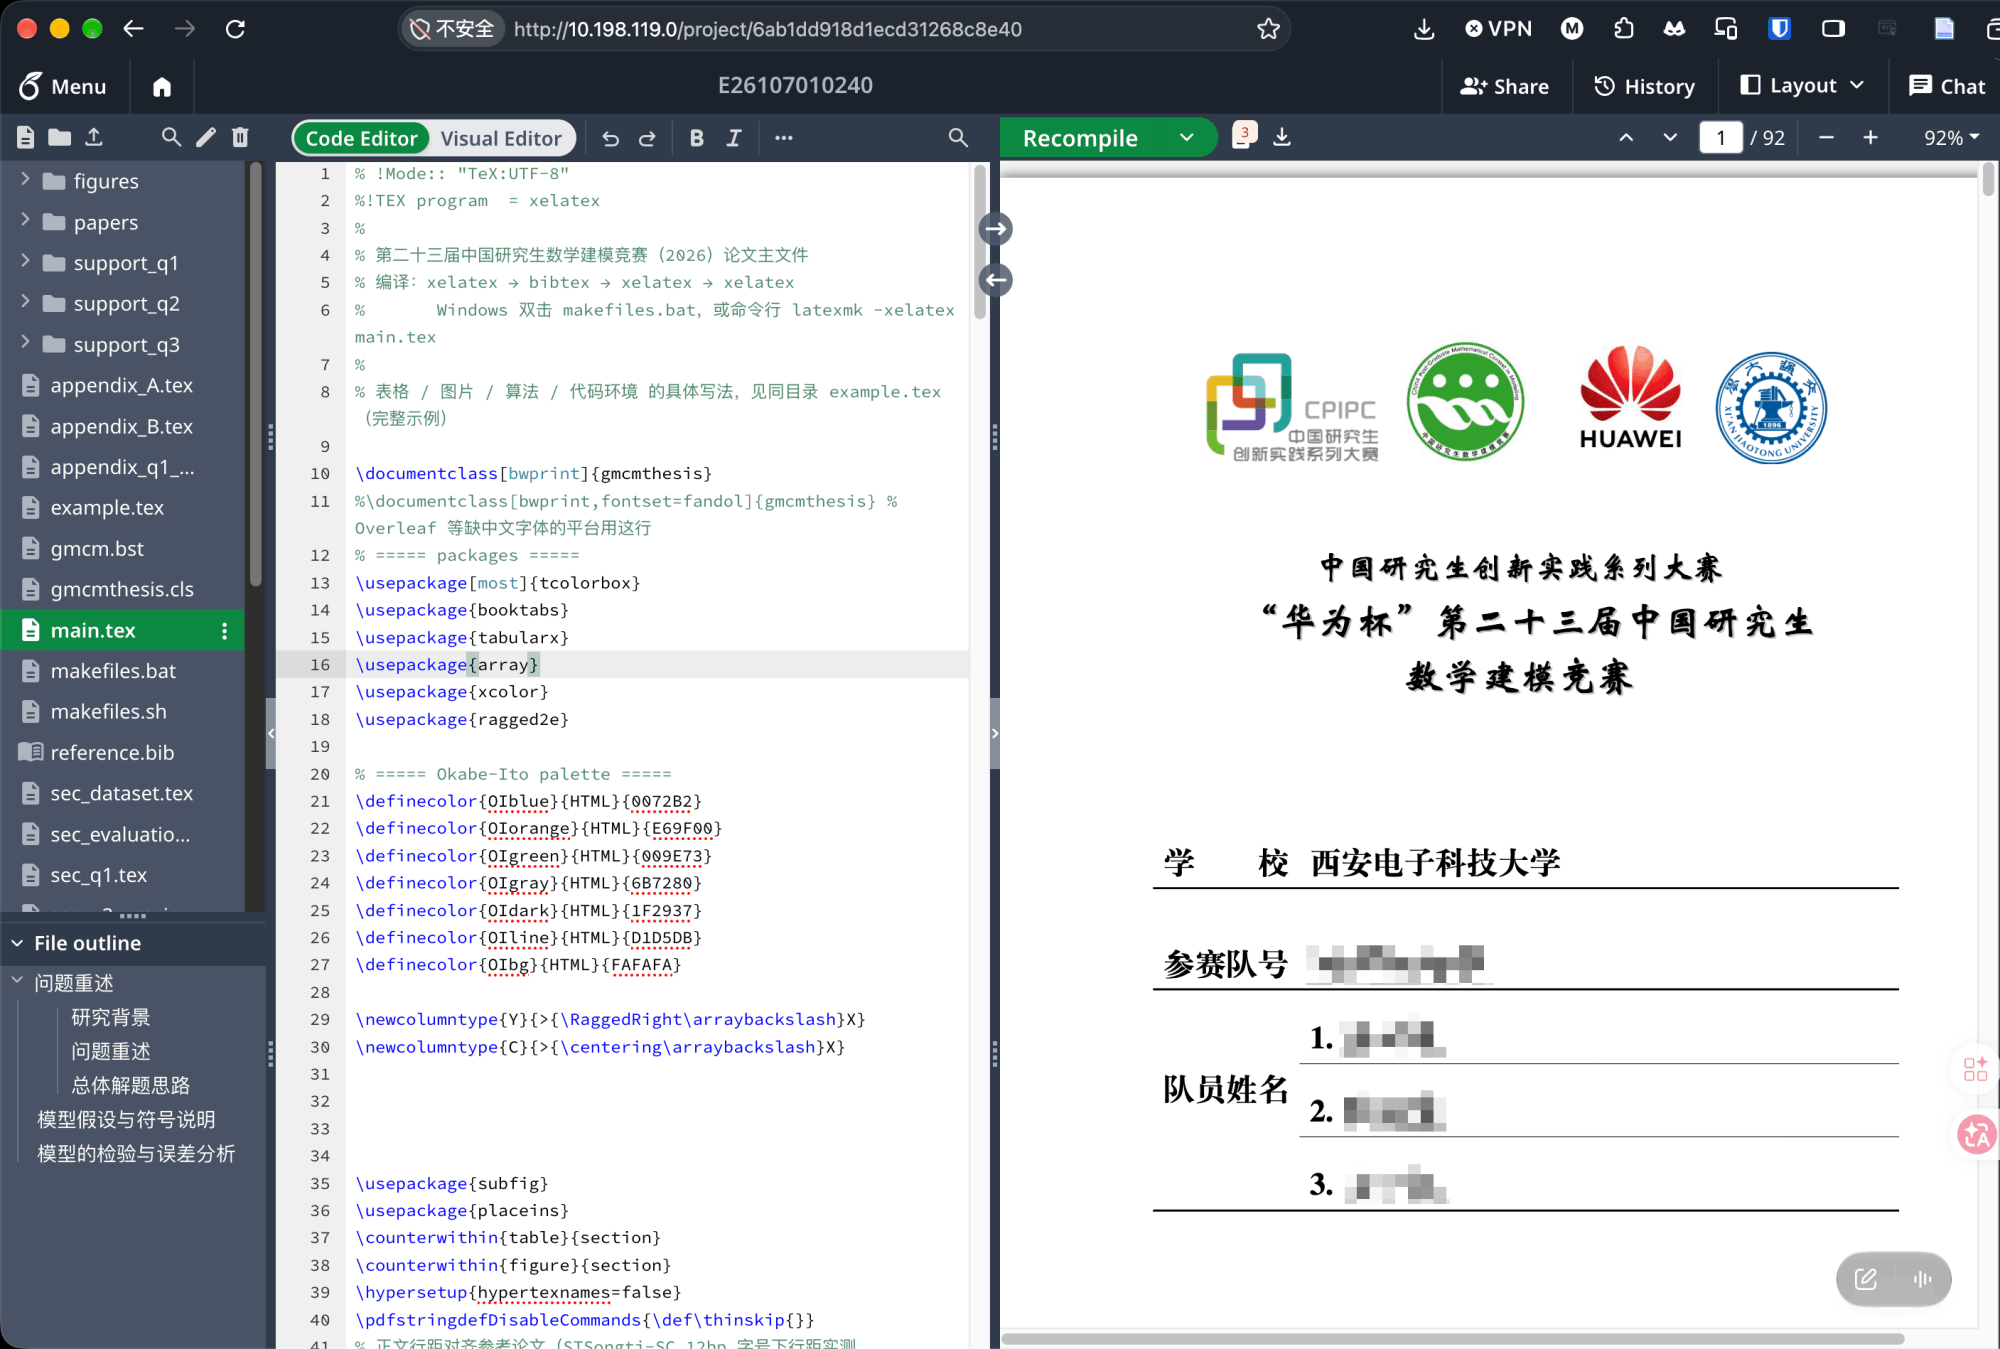
一、为什么自己搭一个 Overleaf
在线版 Overleaf 当然能用,但放在比赛场景里,有三个绕不过去的点:
- 免费版编译慢、协作人数受限,冲刺阶段等一次编译几十秒,很难受
- 宏包受限,数学建模常用的
algorithm2e、booktabs、国标参考文献之类的宏包不一定能随手装 - 数据在别人服务器上,比赛论文虽然不算机密,但心里总归不踏实
自己搭社区版(CE)就全解决了:无限项目、随便装宏包、三个人实时协作,跟 Google Docs 一样的体验。
我之前在 NAS 上完整部署过一套 Overleaf(含域名、HTTPS、外网访问),步骤和踩坑都写在《Overleaf 部署实战指南》里了。这次是另一个场景:比赛现场只有一台 Windows 电脑,不需要公网,只需要"在场的三个人能同时编辑"。所以部署方式完全不同——不搞域名和证书,直接 80 端口映射到校园网。
二、在 Windows 上用 Docker 部署
2.1 三个容器
Overleaf CE 本体是三个服务:Web 应用(sharelatex)+ 数据库(mongo)+ 缓存(redis)。用 Docker 把它们拉起来,宿主机上只需要暴露一个 80 端口。
# docker-compose.yml
services:
  sharelatex:
    image: sharelatex/sharelatex:latest
    container_name: sharelatex
    depends_on:
      - mongo
      - redis
    ports:
      - "80:80"                             # ← 映射到宿主机 80
    volumes:
      - ./data/overleaf:/var/lib/overleaf
      - ./data/texlive:/usr/local/texlive   # ← 宏包持久化,见踩坑表
    environment:
      OVERLEAF_SITE_URL: http://10.198.119.0   # ← 换成你的校园网 IP
      OVERLEAF_NAV_TITLE: Overleaf
      OVERLEAF_ADMIN_EMAIL: you@example.com
      OVERLEAF_MONGO_URL: mongodb://mongo/sharelatex
      OVERLEAF_REDIS_HOST: redis

  mongo:
    image: mongo:8
    volumes:
      - ./data/mongo:/data/db

  redis:
    image: redis:7
    volumes:
      - ./data/redis:/data
docker compose up -d
docker compose ps # 三个容器都是 Up 就对了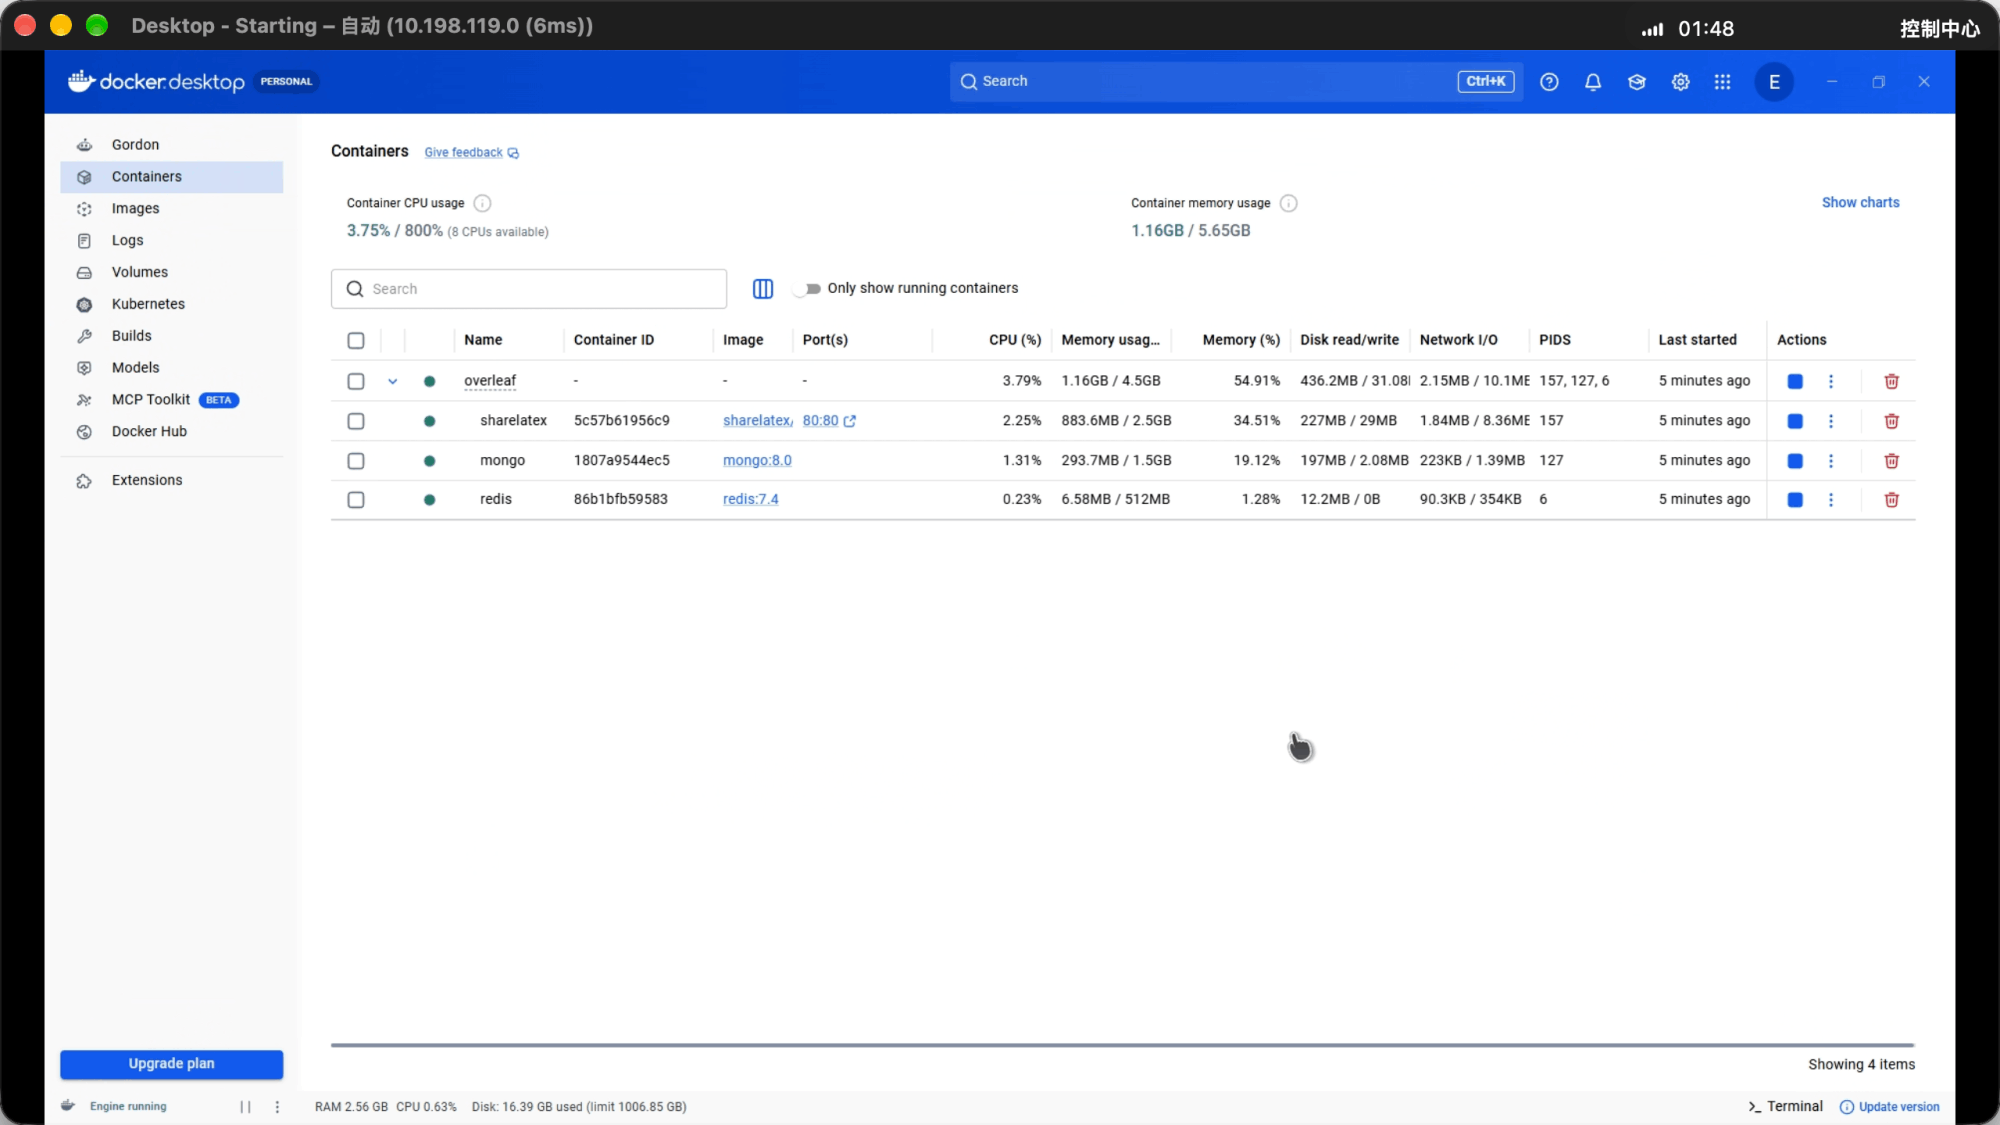
2.2 建三个账号(CE 版没有注册页)
Overleaf 社区版的注册页是写死的,注册不了,只能直接往 MongoDB 里插用户(或者通过邀请别人进行注册)。这部分的完整脚本我在《Overleaf 部署实战指南》里写过。
相关文章Overleaf部署实战指南本文记录在 fnOS NAS 上自建 Overleaf 6.2.2 社区版的完整实战:用 overleaf-toolkit 部署,迁移数据目录到用户可见路径,持久化挂载 eX Live 并切换清华镜像安装 ctex 等宏包,直插 MongoDB 创建管理员账号,最后经 Lucky 反代实现域名 H PS 外网访问与多人协作,并总结 7 个关键踩坑点。我们三个人是按人一人一个账号分配的,邮箱统一用队内的 mcm.com 域名,密码用「姓名缩写 + 年份 + 用途」的格式,好记又不容易记混:
| 账号 | 密码 | 角色 |
|---|---|---|
hwl@mcm.com | HWL2026latex | 管理员 |
skq@mcm.com | SKQ2026latex | 管理员 |
wyh@mcm.com | WYH2026latex | 管理员 |
三、把 Overleaf 共享到校园网
这一步才是这次和上次最大的区别——不需要域名,不需要证书,只需要一个局域网 IP。
3.1 拿到本机在校园网里的 IP
ipconfig
# 找到正在用的那块网卡,记下 IPv4 地址(我们这台是 10.198.119.0)
3.2 放行防火墙
Windows 默认会拦掉入站的 80 端口,队友会看到"无法访问此网站"。加一条入站规则:
netsh advfirewall firewall add rule name="Overleaf-80" dir=in action=allow protocol=TCP localport=803.3 队友访问
把地址发给队友,浏览器打开:
http://10.198.119.0/三个人各自登录自己的账号,进同一个项目——实时协作就成立了。谁在改哪一段,光标都是可见的,公式一边写一边就能看到渲染结果,这比微信传文件强太多。
四、为什么要再落一份到本地文件夹
到这里,"三个人同时编辑"的问题已经解决了。但真正开始写论文之后,我发现光有 Overleaf 还不够:
- 几十页的
.tex在网页编辑器里翻起来很累,跨文件改动更是折磨 - 比赛的图和表是脚本生成的,需要有人(或者有 AI)批量改
- 最关键的一点:AI 读不了 Overleaf 的网页。它只能读磁盘上的文件
于是就有了这次真正的核心:在本地建一个文件夹,让两个 AI 代理都去读它。
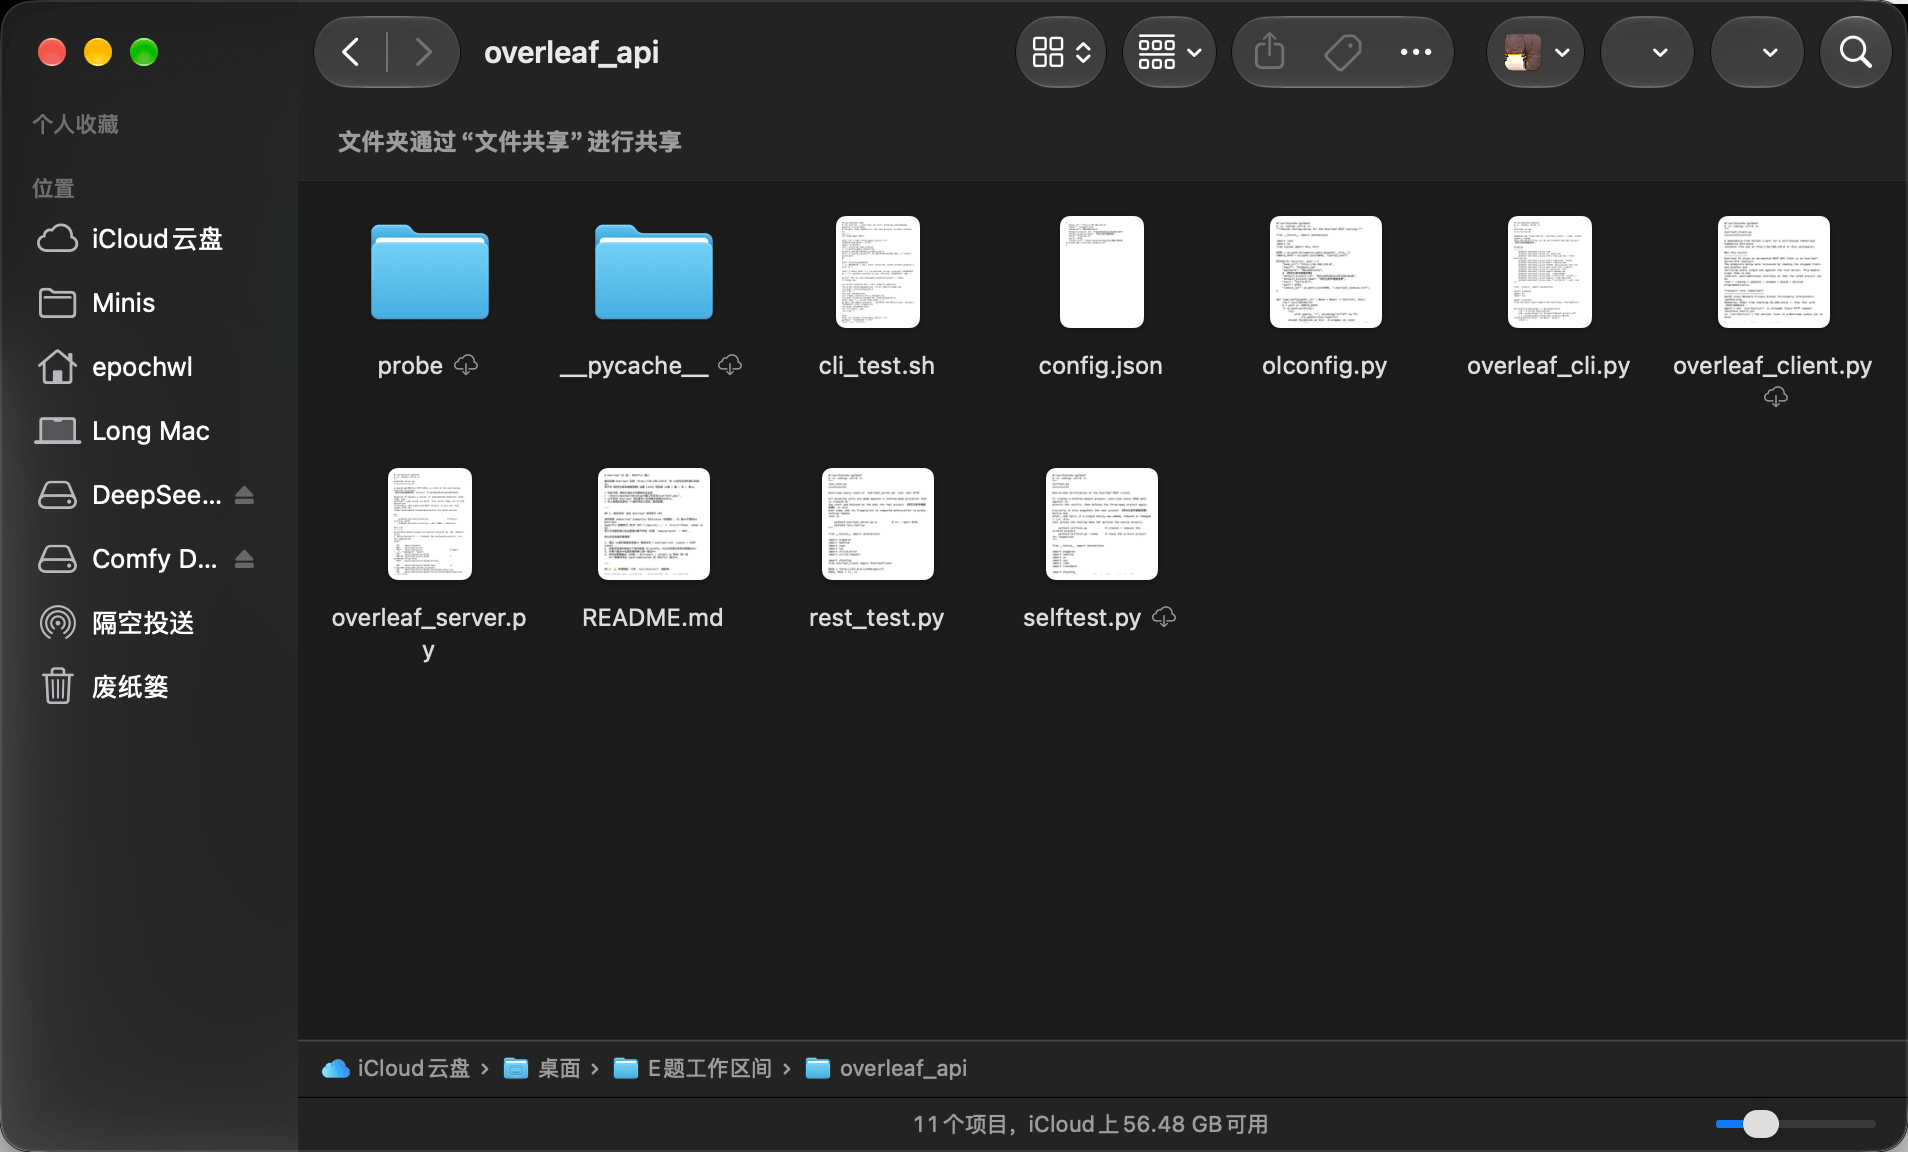
我们最后的工作区长这样:
E题工作区间/
├── E题/paper_local/          ← 论文文件夹(两个 AI 共同读写的唯一接口)
│   ├── main.tex              ← 入口
│   ├── sec_q1.tex            ← 问题一正文
│   ├── sec_q2.tex            ← 问题二正文
│   ├── sec_q3.tex            ← 问题三正文
│   ├── sec_dataset.tex / sec_symbols.tex / sec_validation.tex
│   ├── appendix_A.tex / appendix_B.tex
│   ├── reference.bib
│   ├── figures/              ← 图
│   ├── papers/               ← 参考论文 PDF
│   └── support_q1 ~ q3/      ← 支撑材料代码
│
└── overleaf_api/             ← DeepSeek Harness 逆向出来的接口层
    ├── overleaf_client.py    ← 核心库(curl 传输 + socket.io + CRUD)
    ├── overleaf_cli.py       ← 命令行
    ├── overleaf_server.py    ← 统一 REST 服务
    ├── probe/                ← 逆向过程的探针与证据
└── README.md ← 接口文档注意这个布局的关键点:接口层的代码一行都不放进论文文件夹,两个目录完全分开。论文文件夹里只有论文,AI 看它的时候不会被一堆脚本干扰。
五、双 Agent 分工:一个管同步,一个管写作
先看整体架构:
┌──────────────────────── Windows 电脑 ────────────────────────┐
│                                                              │
│   ┌──────────────┐    ┌────────┐    ┌────────┐               │
│   │  sharelatex  │◄──►│ mongo  │    │ redis  │               │
│   │   容器 :80   │    └────────┘    └────────┘               │
│   └──────┬───────┘                                           │
│          │ 80:80 端口映射                                     │
│   ┌──────▼────────────────────────────────┐                  │
│   │      paper_local/  论文文件夹          │                  │
│   │  main.tex  sec_q*.tex  figures/  ...  │                  │
│   └───┬───────────────────────────▲───────┘                  │
│       │ 读 / 写                    │ pull / push              │
│   ┌───▼────────┐             ┌─────┴──────────────┐          │
│   │   Codex    │             │  DeepSeek Harness  │          │
│   │  负责写作   │             │  负责同步 + 接口层   │          │
│   └────────────┘             └────────────────────┘          │
└──────────────────────────────────────────────────────────────┘
                    ▲ 校园网 80 端口
        ┌───────────┼───────────┐
    队员 A       队员 B      队员 C
   (浏览器)     (浏览器)    (浏览器)
两个 AI 各干一件事,互不干扰。
5.1 DeepSeek Harness:把 Overleaf 逆向成一套 CLI
开题第一天我就发现了一个问题:这台自建 Overleaf 根本没有官方 API。
Overleaf 社区版不提供 SaaS/Pro 那套 /api/v1/... 的 REST 接口,官方文档里的端点在自建实例上直接 404。也就是说,想用脚本操作项目,只有一条路:把它当成一个普通网站,从网页版的行为里把接口抠出来。
所以我让 DeepSeek Harness 做了这件事,完整走完了四步:
- 拿会话:走网页端登录流程,拿到
overleaf.sidcookie 和 CSRF token - 找端点:把它自己下发的前端 JS bundle 扒下来读,从中还原出内部端点
- 逐个实测:每个端点都在真实服务器上验证一遍,宁可不写也不能猜
- 统一封装:把混杂的 JSON / multipart / socket.io 收敛成一套干净的接口
三个真正花时间的点
① 文件树必须走 socket.io
GET /project/:pid/entities 只返回路径,没有 id:
{"project_id":"...","entities":[{"path":"/main.tex","type":"doc"}]}但后续所有增删改查都要用 entity id。id 只能从实时协议里拿——这台实例用的是 socket.io 0.9,WebSocket 升级被 nginx 挡掉了(502),好在 xhr-polling 是纯 HTTP,可以完全用 curl 驱动:
GET  /socket.io/1/?t=<ms>&projectId=<pid>     →  <sid>:60:60:websocket,xhr-polling
GET  /socket.io/1/xhr-polling/<sid>?t=<ms>    →  "1::"
POST /socket.io/1/xhr-polling/<sid>?t=<ms>
     body: 5:1::{"name":"joinProject","args":[{"project_id":"<pid>"}]}
GET  /socket.io/1/xhr-polling/<sid>?t=<ms>    →  joinProjectResponse(带完整目录树)
② 上传接口的两个反直觉设计
| 行为 | 实测结果 |
|---|---|
folder_id 放哪 | 必须在 query string。放 body 一律 422 folder_not_found,而且对根目录、子目录报的错一模一样,极易误判成"目录 id 错了" |
name 字段 | 必需。只给 qqfile 不给 name → 422 invalid_filename。文件名的权威来源是 multipart 的 name,不是 part 的 filename |
③ 最大的坑:macOS 不让第三方解释器访问局域网
这是整个项目里最折磨人的一条,而且跟代码完全无关:
| 程序 | 能否访问 10.198.119.0 |
|---|---|
/usr/bin/curl(Apple 系统自带) | ✅ 可以 |
/usr/bin/nc | ✅ 可以 |
python3(python.org / Homebrew) | ❌ Errno 65 No route to host |
node(Homebrew v22) | ❌ EHOSTUNREACH |
macOS 的本地网络隐私权限只信任 Apple 签名的系统二进制,第三方解释器一律被拒。目标和本机明明在同一个内网段,ping 也通,但 Python 就是连不上。
所以这个项目的 HTTP 传输层全部基于 /usr/bin/curl 子进程,会话存在磁盘上的 Netscape cookie jar 里。这是个刻意的架构决定,不能"顺手改成 requests"——改了直接连不上。
最后沉淀下来的东西
逆向的产出不是一个临时脚本,而是三件可以长期复用的东西(都在 overleaf_api/):
| 文件 | 作用 |
|---|---|
overleaf_client.py | 核心库:curl 传输层、登录、socket.io 客户端、路径寻址的 CRUD |
overleaf_cli.py | 命令行工具:tree / cat / write / mkdir / rm / rename / move / grep / pull / push / compile |
overleaf_server.py | 统一 REST 服务:把零散端点收敛成路径寻址的接口,调用方只用 /main.tex 这种人类路径,完全不需要知道 entity id |
命令行长这样:
python3 overleaf_cli.py tree -r                              # 看整棵树
python3 overleaf_cli.py cat /main.tex                        # 读
python3 overleaf_cli.py write /sec_q1.tex --file sec_q1.tex  # 写(同名即覆盖)
python3 overleaf_cli.py grep '\cite\{' --ext .tex            # 全项目检索
python3 overleaf_cli.py pull ./paper_local                   # 整包拉下来
python3 overleaf_cli.py push ./paper_local --prefix /        # 整个目录推上去
python3 overleaf_cli.py compile --pdf main.pdf               # 触发线上编译并取回 PDF
💡 这一步的价值在于"可复现"。接口被固化成命令 + 文档之后,同步就不再依赖某个人的记忆,也不需要每次打开网页手动上传——后续所有上传修改都是一条命令的事。
一个我很在意的细节:不污染源项目
写接口最怕的事,是测试的时候把真实项目改坏了。所以三套测试(库层 25 项、REST 28 项、CLI 全流程)用的是指纹法:
- 先对真实项目取指纹:
sha256(每个节点的 id|type|path|hash) - 所有写操作只在临时项目
__..._SELFTEST_DO_NOT_USE__上做 - 跑完删掉临时项目
- 再取一次真实项目指纹,不一致就判定失败
最终结果:
selftest.py   ===== 25 passed, 0 failed =====   (真实项目指纹前后一致)
rest_test.py  ===== 28 passed, 0 failed =====   (真实项目指纹前后一致)
真实项目 19 个节点,指纹前后完全相同。
5.2 Codex:只关心论文怎么写
Codex 那边就简单了:它只读同一个文件夹(paper_local/)。
它的职责是纯粹的写作:
- 读
main.tex和sec_q*.tex,理解当前论文结构 - 补写、润色问题一到问题三的正文,统一符号与术语
- 生成三线表、改写摘要、检查交叉引用和公式编号是否断裂
它不需要知道 Overleaf 在哪、端口是多少、cookie 怎么带、socket.io 怎么握手——这些全被隔离在接口层了。
5.3 为什么不让一个 AI 全干
这是我这次体会最深的一点。把"同步"和"写作"交给同一个代理,会出两个问题:
- 上下文被污染:socket.io 的分帧格式、
422报错、cookie 过期这些细节会挤占写作需要的长上下文,写到后面它已经忘了前面用过什么符号 - 职责边界模糊:一旦论文出了问题,你分不清是"文件没同步对"还是"内容写错了"
拆开之后,两个代理各自有一个非常清晰的成功标准:同步代理的成功标准是"本地与线上完全一致",写作代理的成功标准是"这一节写得好"。排查问题时,责任一目了然。
六、这次协作真正的收获
比赛结束后回头看,我觉得最有价值的不是"搭了一个 Overleaf",而是把协作拆成了两层:
第一层是人跟人的协作。Overleaf 解决的是"三个人同时写一篇 LaTeX"这件事——不用合并文件、不用对齐版本、不用问"你改到哪了"。这一层的关键是把服务放在所有人都够得着的地方,所以"校园网内网共享"这个看起来最土的做法,反而是最合适的:不依赖公网、不依赖域名、不依赖任何第三方服务。
第二层是人和 AI 的协作。DeepSeek Harness 负责同步,Codex 负责写作,paper_local/ 这个文件夹是它们共同的接口。这一层的关键是职责单一:一个代理只做一件事,成功标准清清楚楚。
总结
四天四小时,这套链路是这样的:
- 部署:Windows + Docker 起 Overleaf,80 端口映射到校园网,三个人浏览器直接访问
- 协作:实时共同编辑一份 LaTeX,谁改哪里一目了然
- 逆向:DeepSeek Harness 把没有官方 API 的 Overleaf CE 逆向成一套 CLI 和 REST 服务
- 写作:Codex 读本地
paper_local/,专心写论文 - 回传:本地文件一变,DeepSeek Harness 识别到变化并 push 回线上
- 收口:线上编译出 PDF,交 MD5 码前把版本彻底对齐
本文由 DeepSeek Harness 根据本次华为杯数学建模的实践过程整理,环境:Windows + Docker Desktop 自建 Overleaf CE,macOS 客户端(笔者),三人小队协作。